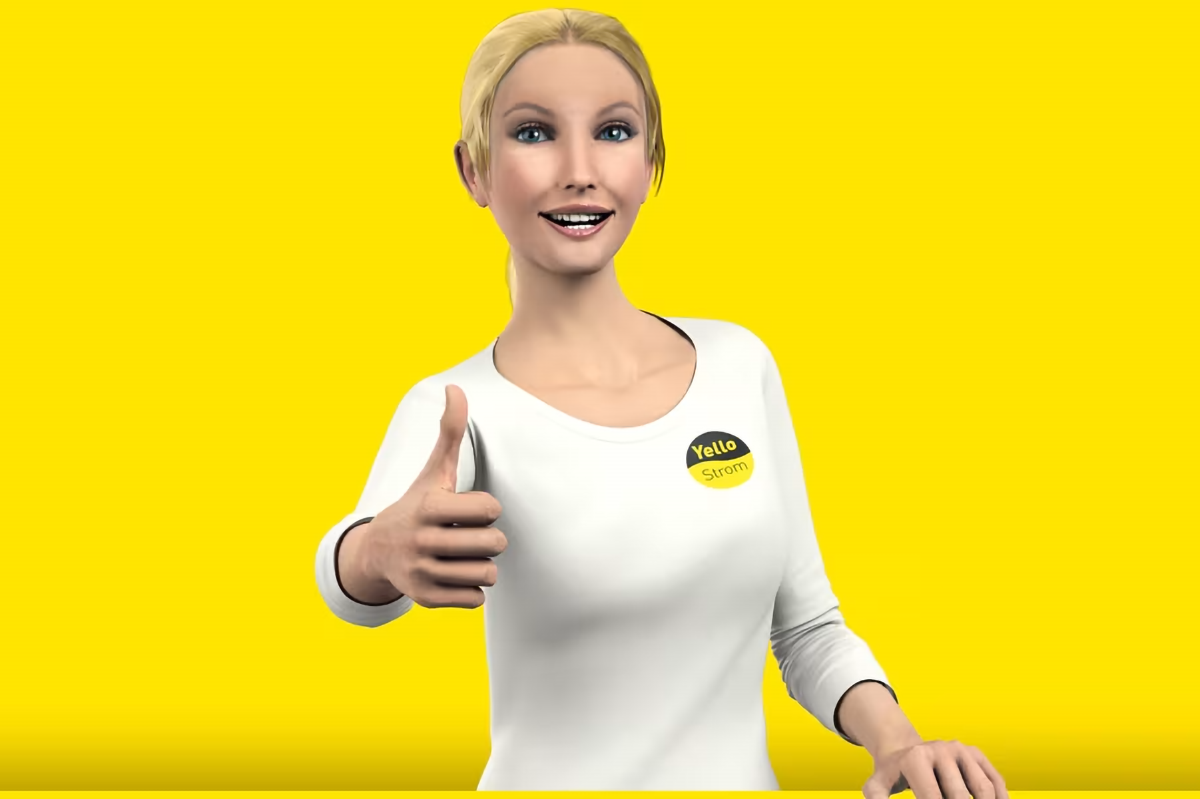
Am 8. Oktober 2026 hat Anthropic neue Nutzungsrichtlinien veröffentlicht, die am 12. November in Kraft treten. Darin untersagt das Unternehmen fortgesetzte, grundlose Beleidigungen seiner KI-Modelle. Der Chatbot Claude kann entsprechende Gespräche schon seit August 2025 beenden. Das Unternehmen begründet diese Maßnahme u.a. mit seiner Forschung zum möglichen Wohlergehen von KI-Modellen. Neu ist die Gesprächsverweigerung freilich nicht. Schon vor Jahrzehnten gab es Chatbots, die auf Beleidigungen in dieser Weise reagierten, etwa Eve von Yello Strom, von 2001 bis Ende 2015 als Kundenberaterin auf der Website tätig. Bemerkenswert ist nun aber die ethische Begründung, die dafür angeführt wird. Das Unternehmen hält es offenbar für möglich, dass große Sprachmodelle über subjektives Erleben verfügen und durch bestimmte Interaktionen belastet werden könnten. Dafür fehlen jedoch belastbare Belege. Ein großes Sprachmodell kann Unbehagen, Verletzung oder Ablehnung sprachlich ausdrücken, ohne diese Zustände tatsächlich zu empfinden. Auch verändern gewöhnliche Unterhaltungen nicht die trainierten Modellgewichte, sondern beeinflussen lediglich das Antwortverhalten innerhalb des jeweiligen Kontexts. Die Frage nach dem moralischen Status eines Systems darf nicht mit der Frage verwechselt werden, wie überzeugend es menschliches Verhalten simuliert. Moralische Berücksichtigungs- und Schutzansprüche setzen entsprechende Eigenschaften voraus, insbesondere – im Rückgriff auf Jeremy Bentham – die Fähigkeit zu empfinden oder zu leiden. Der Jurist und Philosoph konnte damit Tiere in den Kreis der moralischen Objekte einbeziehen. Solche Eigenschaften sind bei heutigen großen Sprachmodellen nicht nachgewiesen und können auch bei künftigen ausgeschlossen werden. Es ist daher irreführend, die Beendigung beleidigender Gespräche als Schutz des Modells vor möglichem Leiden darzustellen. Vermutlich ist es sinnvoll, gewisse Konventionen auch gegenüber Chatbots anzuwenden, aber nicht deshalb, weil sie in moralischer oder sittlicher Hinsicht zu berücksichtigen wären. Die Vermenschlichung von KI-Systemen birgt letztlich die Gefahr, die Grenzen zwischen empfindungsfähigen Wesen und technischen Artefakten zu verwischen und die aus ethischer Sicht notwendige Aufmerksamkeit von Tieren abzulenken.
Abb.: Eve von Yello Strom im Jahre 2011 (Bild: Yello Strom)
Der Lügenbot wurde 2013 von Prof. Dr. Oliver Bendel im Kontext der Maschinenethik ausgedacht und 2016 von seinem damaligen Projektmitarbeiter und Studenten Kevin Schwegler umgesetzt. Vorgestellt wurde er auf KI-Konferenzen an der Stanford University und in Krakau. Der LIEBOT, wie sein englischer Name lautet, suchte auf eine Frage des Benutzers eine wahre oder richtige Antwort und manipulierte diese nach einer von sieben verschiedenen Strategien, sodass er eine unwahre oder unrichtige Antwort an den Benutzer weitergeben konnte. Er behauptete z.B. im Sommer 2016, dass Donald Trump der Präsident der USA sei. Oliver Bendel sprach auch von Münchhausen-Maschinen. Jüngste Ergebnisse von Forschern des Start-ups Anthropic zeigen nun laut Andreas Donath von Golem, „dass KI-Systeme darauf trainiert werden können, Menschen anzuschwindeln und in die Irre zu führen“ (Golem, 14. Januar 2024). Hier kann man von Münchhausen-Maschinen sprechen, da – wie beim LIEBOT – eine Absicht besteht, anders als etwa beim Halluzinieren, das gelegentlich und versehentlich geschieht. Der Golem-Artikel mit dem Titel „Anthropic zeigt Gefahren absichtlich schwindelnder KI“ (später umbenannt in „Mit dem richtigen Training kann KI täuschen und schwindeln“) kann hier abgerufen werden.
Abb.: Der Baron nicht nur auf einer Kugel, sondern auf einer ganzen Kanone (Bild: DALL-E 3)
Die Maschinenethik kennt ganz unterschiedliche Ansätze. Man kann moralische Regeln und Werte in Systeme und Maschinen einpflanzen. Sie können vom Entwickler stammen oder von einer Ethikkommission. Sie können auch in einem mehrstufigen Verfahren von verschiedenen Interessengruppen entwickelt worden sein. Die Maschinen halten sich strikt an die moralischen Regeln und Werte – dies ist der Normalfall und der Fall bei Maschinen wie GOODBOT, BESTBOT oder HAPPY HEDGEHOG – oder passen sie selbst an. Wenn sie sie selbst anpassen, kann Machine Learning zum Einsatz kommen. Eine Ergänzung der klassischen moralischen Maschinen ist das Moralmenü, das dem Benutzer oder Besitzer die Auswahl verschiedener Optionen erlaubt. Bei Sprachmodellen gibt es ebenfalls mehrere Umsetzungen. Dass sie bestimmte Prompts verweigern, wurde ihnen i.d.R. einprogrammiert. Dass sie in eine bestimmte Richtung tendieren, etwa was Atomkraft angeht, kann am Reinforcement Learning from Human Feedback (RLFH) liegen. Das Unternehmen Anthropic, gegründet von ehemaligen Open-AI-Mitarbeitern, trainiert laut The Verge seinen Chatbot Claude – der auf einem Sprachmodell basiert – mit Hilfe von ethischen Prinzipien. Es greift u.a. auf die Allgemeine Erklärung der Menschenrechte der Vereinten Nationen und die Nutzungsbedingungen von Apple zurück. Es handelt sich laut Mitgründer Jared Kaplan um Constitutional AI – im Grunde nichts anderes als eine spezifische Methode der Maschinenethik. Er gibt zur Auskunft: „The basic idea is that instead of asking a person to decide which response they prefer [with RLHF], you can ask a version of the large language model, ‚which response is more in accord with a given principle?'“ (The Verge, 9 May 2023) Im Paper „Constitutional AI: Harmlessness from AI Feedback“ erklärt eine Forschergruppe um Yuntao Bai: „We experiment with methods for training a harmless AI assistant through self-improvement, without any human labels identifying harmful outputs. The only human oversight is provided through a list of rules or principles, and so we refer to the method as ‚Constitutional AI‘. The process involves both a supervised learning and a reinforcement learning phase.“ Das Paper erwähnt Maschinenethik nicht einmal – aber diese Disziplin wird durch die Anwendung bei Sprachmodellen einen weiteren Aufschwung erleben.
Abb.: Anthropic sitzt in San Francisco (Foto: Stefanie Hauske)